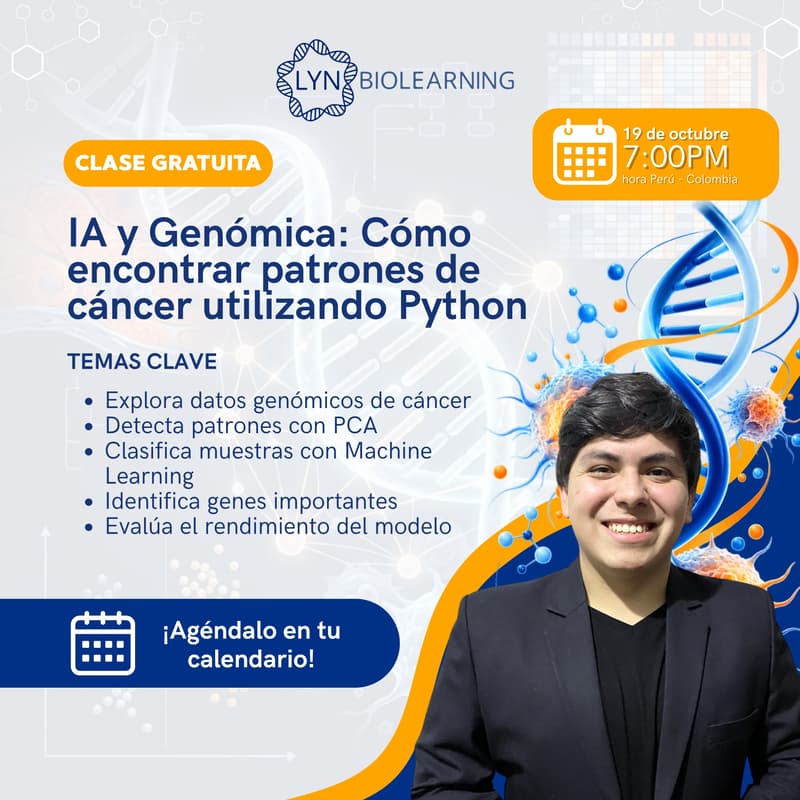

|🧬 ¡Clase Gratuita Online! De miles de genes a una predicción: Machine Learning aplicado al cáncer
🧬 ¡Clase Gratuita Online! De miles de genes a una predicción: Machine Learning aplicado al cáncer
Los datos genómicos pueden contener información de miles de genes simultáneamente. Esta alta dimensionalidad plantea un desafío: identificar patrones útiles dentro de una gran cantidad de variables y convertirlos en información que pueda analizarse mediante herramientas computacionales.
Las técnicas de Machine Learning permiten explorar este tipo de datos, reducir su dimensionalidad y construir modelos capaces de clasificar muestras a partir de patrones presentes en la expresión génica.
En esta clase gratuita conocerás un flujo introductorio y aplicado que parte de una matriz de expresión génica y avanza hacia la construcción y evaluación de un modelo de clasificación utilizando Python.
Exploraremos conceptos como preprocesamiento y estandarización, Análisis de Componentes Principales (PCA), separación entre entrenamiento y prueba, selección de características y evaluación del rendimiento del modelo.
🔗 Únete a nuestro grupo de WhatsApp y comunidad para recibir materiales y recordatorios de la “Clase Gratuita: De miles de genes a una predicción: Machine Learning aplicado al cáncer”
¿Qué verás en esta clase?
• Qué son los datos de expresión génica.
• Cómo se representa computacionalmente una muestra biológica.
• Conceptos de muestras, genes, variables y clases.
• Qué significa trabajar con datos de alta dimensionalidad.
• Exploración inicial de una matriz de expresión génica.
• Visualización mediante heatmaps.
• Preparación y estandarización de datos.
• Introducción a reducción de dimensionalidad.
• Aplicación de PCA.
• Separación entre entrenamiento y prueba.
• Entrenamiento de un algoritmo de clasificación.
• Obtención de predicciones.
• Introducción a selección de características.
• Identificación de variables relevantes.
• Evaluación con accuracy, precision, sensibilidad y F1-score.
• Matriz de confusión.
• Introducción a curvas ROC.
A tomar en cuenta
💻 La clase se realizará de forma virtual mediante Google Meet.
📅 Lunes 19 de octubre
🇲🇽 México: 6:00 p. m.
🇵🇪 Perú | 🇨🇴 Colombia | 🇪🇨 Ecuador: 7:00 p. m.
🇧🇴 Bolivia | 🇻🇪 Venezuela: 8:00 p. m.
🇨🇱 Chile | 🇦🇷 Argentina: 9:00 p. m.
💻 Trabajaremos con Google Colab, Python, Pandas, NumPy, Matplotlib y Scikit-Learn.
✅ No se requiere experiencia previa en Machine Learning.
✅ No se requiere experiencia avanzada en Python.
Se recomiendan conocimientos básicos de biología molecular, genética o ciencias biomédicas.
Dinámica
Comenzaremos comprendiendo cómo se estructura una matriz de expresión génica y qué significa trabajar con miles de variables simultáneamente.
Luego prepararemos y estandarizaremos los datos y conoceremos cómo PCA puede utilizarse para reducir dimensionalidad y representar las muestras en un espacio más sencillo de visualizar.
A continuación, recorreremos un flujo introductorio de clasificación: separación entre entrenamiento y prueba, entrenamiento del modelo y generación de predicciones.
Finalmente, revisaremos cómo evaluar su desempeño utilizando métricas como accuracy, precision, sensibilidad y F1-score, además de la matriz de confusión y una introducción a curvas ROC.
👨🏫 Docente: Luis Alejandro Pérez Timaná
Genetista y biotecnólogo por la Universidad Nacional Mayor de San Marcos, con experiencia en programación aplicada a las biociencias mediante Python.
Sus áreas de especialización incluyen bioinformática, análisis de datos multi-ómicos, inteligencia artificial aplicada a la biomedicina, genética molecular e ingeniería genética.
💬 ¿Tienes preguntas?
Podrás dejarlas en el chat del evento y las responderemos durante la sesión.
LYN BIOLEARNING 🧬💙