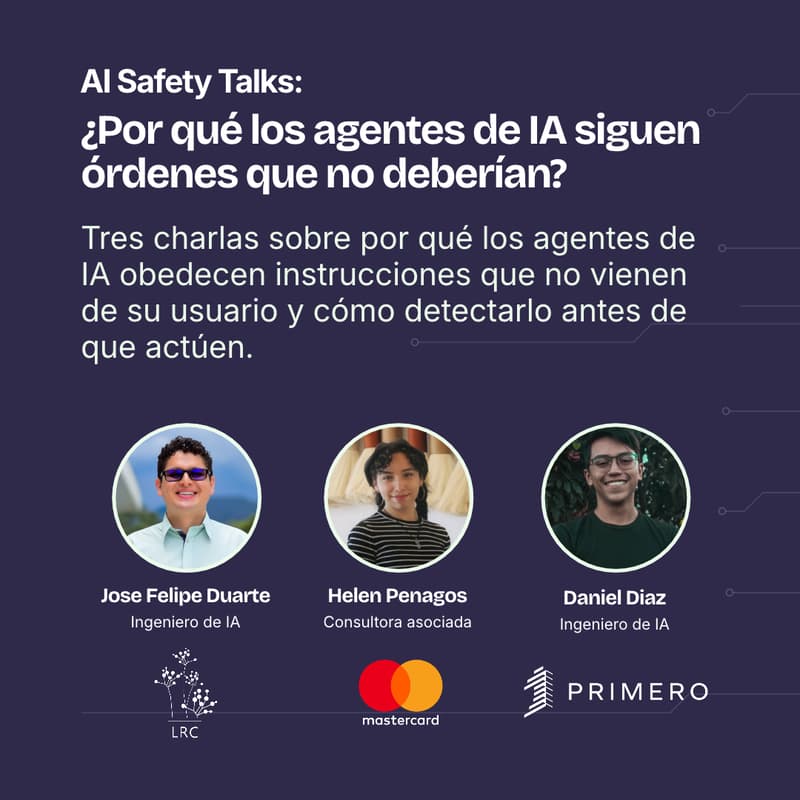

¿Por qué los agentes de IA siguen órdenes que no deberían?
AI Safety Talks es una serie de encuentros para explorar distintos problemas y líneas de investigación en seguridad de inteligencia artificial, con personas con investigación en el campo.
En esta segunda edición nos vemos en persona. Hablaremos de agentes de IA con acceso a herramientas: por qué a veces siguen instrucciones que no deberían y cómo detectarlo antes de que actúen.
Charlas:
Jose Felipe Duarte (Laboratory for Research in Complex Systems)
Los asistentes de IA pueden obedecer instrucciones maliciosas escondidas en correos o páginas web. Jose Felipe mostrará por qué los modelos no siempre distinguen entre órdenes legítimas y ajenas, y cómo corregirlo.
Helen Penagos (Mastercard)
Un modelo que rechaza peticiones dañinas en un chat puede cumplirlas cuando actúa como agente y usa herramientas. Helen explicará por qué ocurre y cómo detectar señales internas de estas fallas.
Daniel Diaz (Primero, ex-Microsoft)
Las instrucciones maliciosas pueden ocultarse en documentos o páginas web. Daniel presentará MnM, un sistema que monitorea las entradas y el razonamiento del modelo para detectar estos ataques, incluso en idiomas desconocidos.
No necesitas experiencia previa en AI safety para participar. Las charlas serán en español y habrá espacio para preguntas.
Agenda:
4:30 p. m. Llegada
5:00 p. m. Charlas y preguntas
6:30 p. m. Espacio social y de networking
🍹 Invitamos una bebida sin alcohol a cada asistente.
🎟️ Entrada libre, con registro previo. Cupos limitados.
Organiza AI Safety Colombia.